
작성자: 컴맹 집사
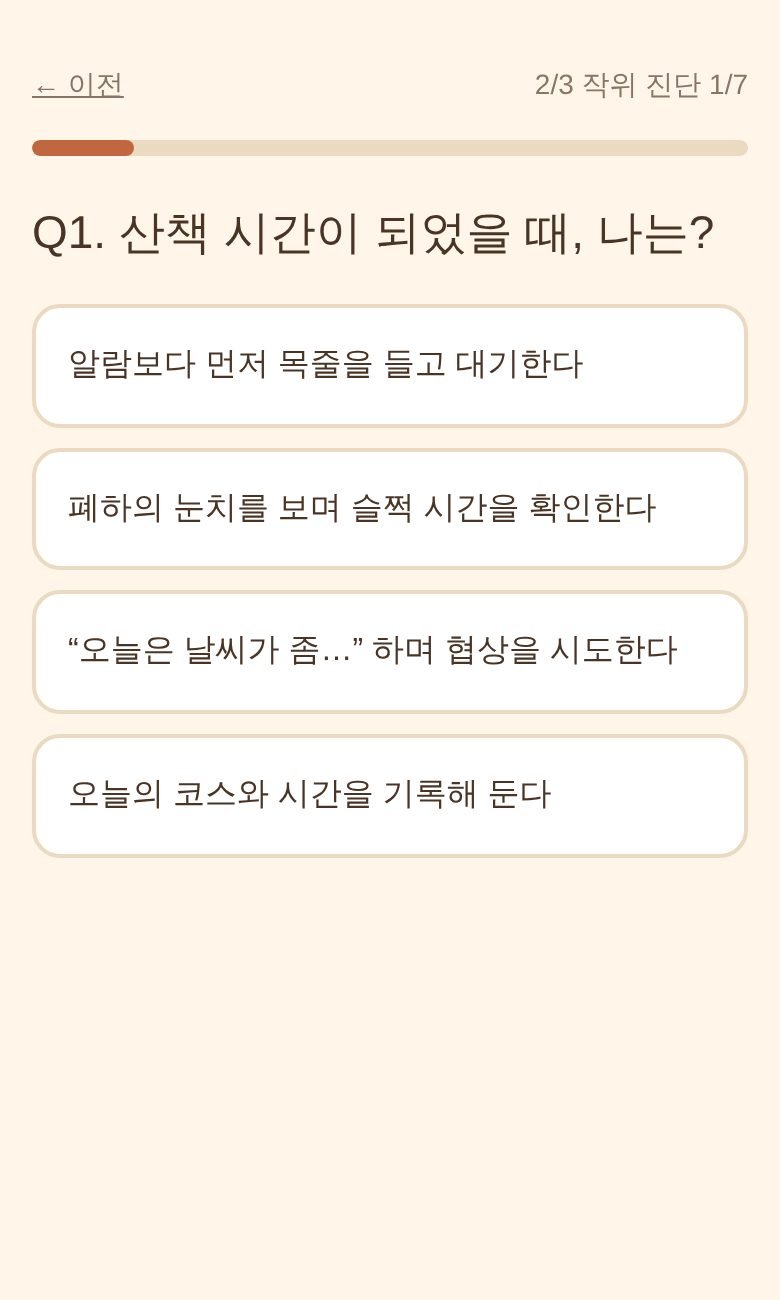
대표 이미지: 7개 질문 중 두 번째 질문 화면 (출처: 왕립 개집사협회 앱 2026년 9월 19일 버전 화면, 직접 캡처)
이 글에서 얻는 것
- 이런 분께 질문에 답하면 유형이 나오는 테스트를 만들고 싶은 분
- 핵심 답 보기마다 점수를 줄 유형을 정해 두고, 고를 때마다 1점씩 더해 가장 높은 유형을 결과로 보여 준다
- 바로 쓰는 팁 질문은 “누구나 겪어 본 상황인가, 보기끼리 확실히 다른가, 답하면서 웃을 수 있는가”로 거르자
“어떻게 답해도 비슷한 작위만 나와.”
첫 버전을 해 본 친구의 말이다. AI가 처음 만들어 준 앱은 질문도 있고 결과도 있었지만, 질문과 결과가 어떻게 이어지는지는 내가 신경 쓰지 않았다. 그 연결을 AI에게 맡겨 두니 결과가 한쪽으로 쏠렸다.
테스트 앱의 핵심은 질문 → 답 → 결과의 연결이다. 이 글은 왕립 개집사협회 앱에서 그 연결을 처음부터 다시 설계한 과정을 적는다.
무엇을 묻는 테스트인가부터 정했다
처음 헷갈렸던 건 “누구를 진단하느냐”였다. 폐하(강아지)의 성격은 앞 화면에서 보호자가 직접 고른다. 그러니 질문 7개는 폐하를 모시는 나, 즉 집사가 어떤 사람인지를 묻는 질문이어야 했다. 이 방향을 정하자 질문 후보를 고르는 기준도 분명해졌다.
질문 개수는 왜 7개였나
처음에는 10개를 생각했다. 직접 해 보니 8번째쯤에서 지루해졌다. 반대로 5개는 결과가 너무 가볍게 느껴졌다. AI에게 물으니, 가볍게 즐기는 테스트는 대체로 1분 안팎에 끝나는 게 좋고, 질문 하나에 5~8초쯤 걸린다고 봐서 7~10개가 적당하다고 했다. 다만 이 숫자는 AI의 일반적인 답이라, 나는 직접 시간을 재 보았다. 7개가 1분이 채 안 걸렸다. 첫 화면의 “정보 입력 → 질문 7개 → 작위증 발급” 순서와도 잘 맞았다.
질문을 고른 기준
AI에게 후보 질문을 20개쯤 받은 뒤 아래 기준으로 걸렀다. 후보는 제미나이와 챗GPT에서 각각 받아 겹치는 것과 참신한 것을 비교했다.
- 반려인이라면 누구나 겪어 본 상황인가. 산책, 목욕, 간식처럼 누구나 떠올릴 수 있어야 한다.
- 세계관 말투로 물을 수 있는가. “강아지가 목욕을 싫어하면?” 대신 “폐하가 목욕을 단호히 거부하신다면?”처럼 묻는다.
- 보기끼리 확실히 다른가. 보기 두 개가 비슷하면 사용자가 고민만 한다.
- 재미있는가. 답하면서 “이거 완전 나잖아” 하고 웃을 수 있어야 한다.
최종 7개는 이렇다.
- 산책 시간이 되었을 때, 나는?
- 폐하가 목욕을 단호히 거부하신다면?
- 왕실 장난감이 감쪽같이 사라졌다!
- 폐하가 초롱초롱한 눈으로 간식을 요구하신다.
- 폐하와 함께하는 시간은 나에게?
- 왕실 업무가 산더미처럼 밀렸다!
- 새벽 세 시, 폐하의 갑작스러운 명령이 내려졌다.
집사 유형 7가지와 작위 5단계
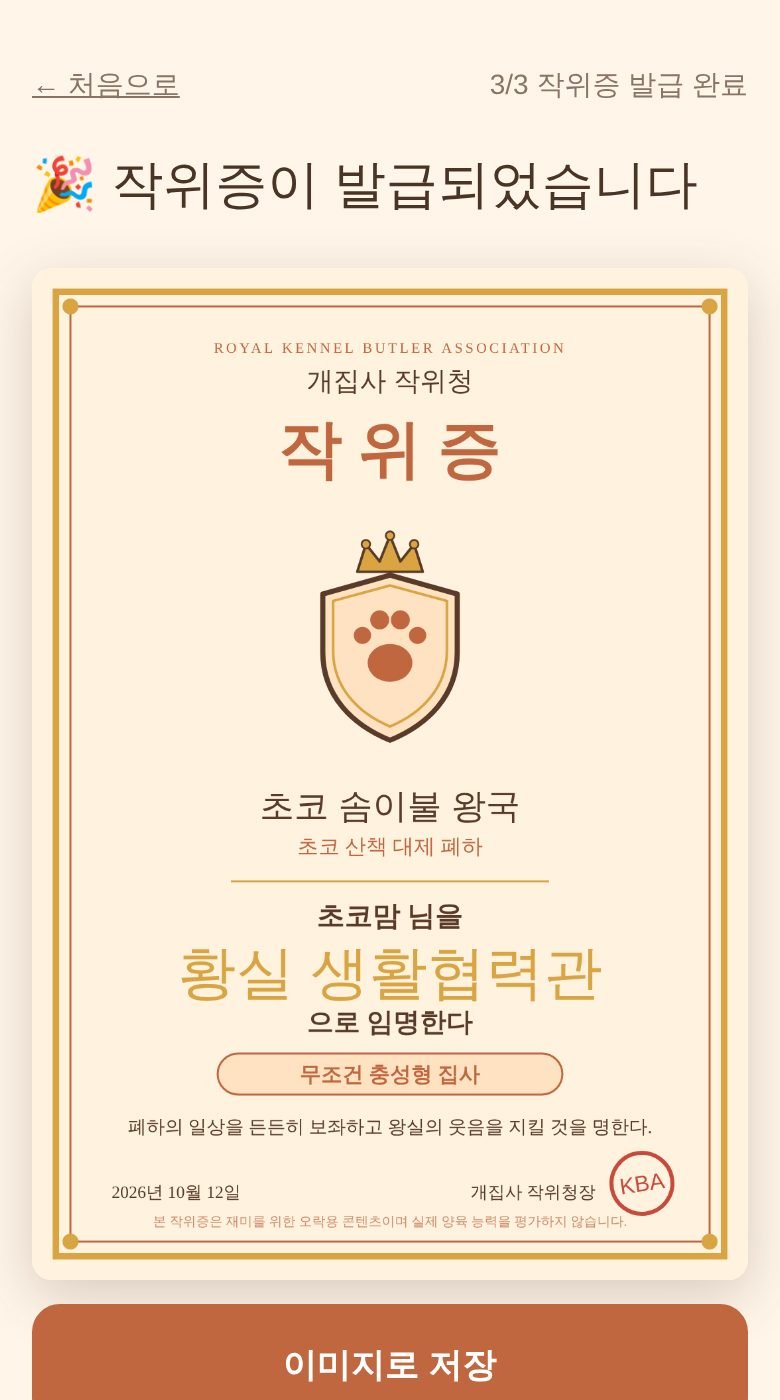
결과는 두 겹으로 나오게 했다. 먼저 집사 유형이 정해지고, 유형에 따라 작위가 정해진다.
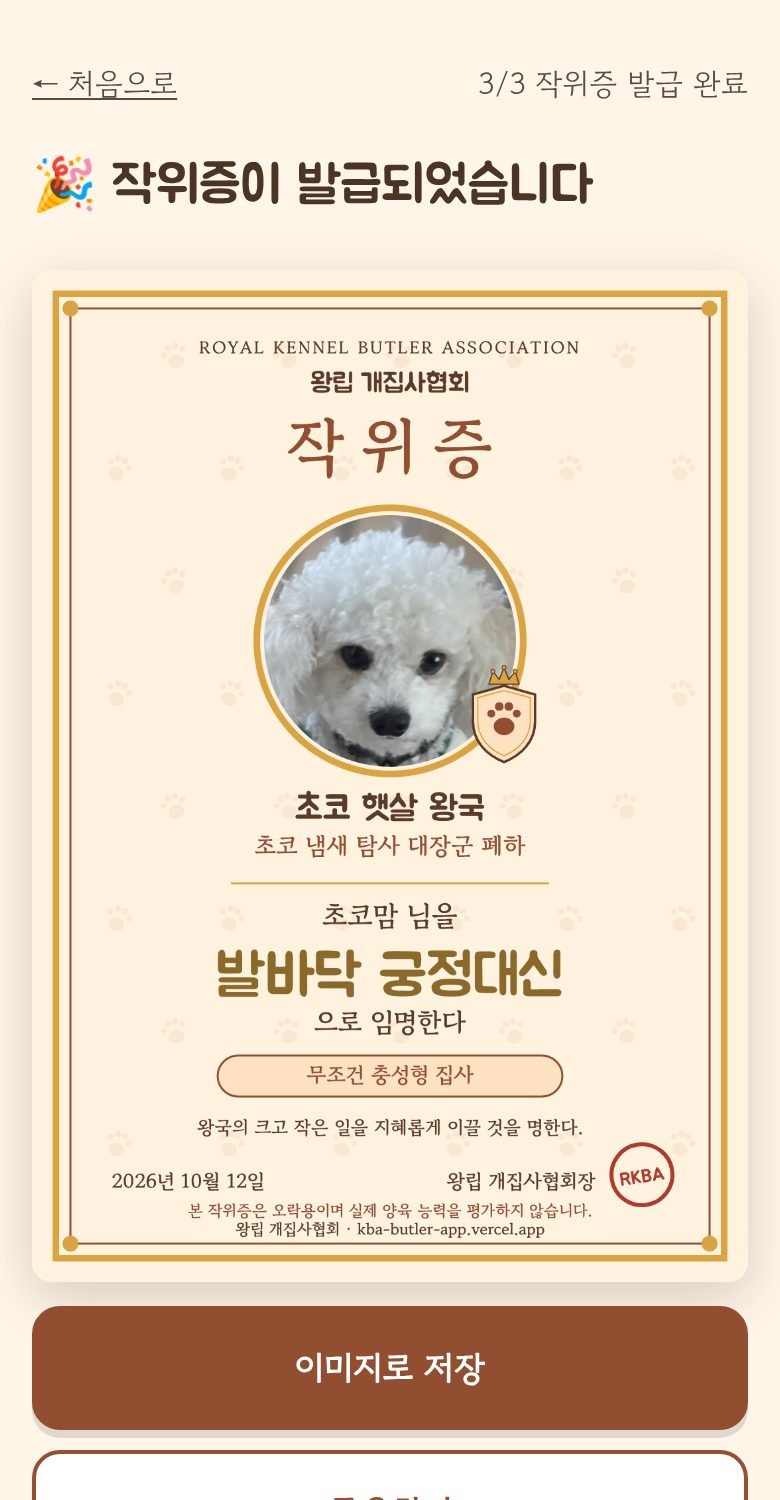
출처: 왕립 개집사협회 앱 2026년 9월 19일 버전 화면, 직접 캡처
| 집사 유형 | 받는 작위 |
|---|---|
| 전략적 회피형 집사 | 1단계 견국 수습집사 |
| 간식 협상형 집사 | 2단계 왕실 생활협력관 |
| 과잉보호형 집사 / 왕실 기록형 집사 | 3단계 왕실 돌봄근위관 |
| 무조건 충성형 집사 / 산책 원정대장 | 4단계 발바닥 궁정대신 |
| 평화 유지 전문관 | 5단계 왕실 총집사 |
처음에는 작위를 “1등급, 2등급”으로 표시했다. 보통 “1등급”은 가장 높은 것으로 받아들여진다. 우리 앱에서 1은 가장 처음 단계인 수습집사라서 헷갈렸다. 그래서 “등급” 대신 “단계”로 바꿨다. 단어 하나를 바꾸자 오해가 사라졌다.
보기마다 점수를 매기는 방식
AI에게 “질문 답에 따라 일곱 가지 유형이 골고루 나오게 하려면 어떻게 설계해?”라고 묻자, 가장 흔한 방식으로 점수 방식을 알려 줬다.
- 각 질문의 보기 네 개는 어떤 집사 유형에 점수를 주는지 정해 둔다.
- 사용자가 보기를 고를 때마다 그 유형에 1점을 더한다.
- 일곱 문제가 끝나면 점수가 가장 높은 유형이 결과가 된다.
1번 질문은 이렇게 설계했다.
| 보기 | 점수가 가는 유형 |
|---|---|
| 알람보다 먼저 목줄을 들고 대기한다 | 산책 원정대장 |
| 폐하의 눈치를 보며 슬쩍 시간을 확인한다 | 무조건 충성형 |
| “오늘은 날씨가 좀…” 하며 협상을 시도한다 | 전략적 회피형 |
| 오늘의 코스와 시간을 기록해 둔다 | 왕실 기록형 |
첫 버전에서 결과가 쏠렸던 이유도 이때 알았다. 처음에는 보기마다 1~4점을 주고 합계로 결과를 나눴는데, 대부분 사람이 중간쯤 답하니 합계가 가운데 구간에 몰렸다. 게다가 가장 높은 5단계 작위는 처음부터 결과로 나오지 않게 짜여 있었다. 유형별로 점수를 따로 모으는 방식으로 바꾸고, 다섯 단계 모두 결과로 나올 수 있게 연결을 다시 짜자 결과가 골고루 나뉘었다.
일곱 유형이 골고루 나오는지 점검했다
질문 7개 × 보기 4개 = 28개 보기가 각각 어느 유형에 점수를 주는지 표로 세어 보았다. 한 유형이 너무 자주 나오면 그 유형만 결과로 몰리고, 너무 적게 나오면 거의 볼 수 없는 유형이 된다. 몇몇 보기의 유형을 바꿔 균형을 맞췄다. 이 표 작업은 AI에게 세어 달라고 부탁하면 금방 끝났다.
질문을 코드 속 목록으로 관리하기
질문을 고칠 때마다 코드 여기저기를 뒤지는 게 불편했다. AI에게 “질문과 보기를 한 곳에 모아 관리하기 쉽게 바꿔 줘”라고 하자, 질문과 문구만 모아 둔 데이터 파일을 만들어 줬다.
const QUESTIONS = [
  { q: '산책 시간이 되었을 때, 나는?', options: [
    { t: '알람보다 먼저 목줄을 들고 대기한다', type: 'walk' },
    { t: '폐하의 눈치를 보며 슬쩍 시간을 확인한다', type: 'loyal' },
    { t: '“오늘은 날씨가 좀…” 하며 협상을 시도한다', type: 'evade' },
    { t: '오늘의 코스와 시간을 기록해 둔다', type: 'record' } ] },
  // 2번~7번 질문도 같은 모양으로 이어진다
];
여기서 배열(array)을 처음 배웠다. (출처: MDN 웹 문서, Array) 대괄호 [ ] 안에 여러 개를 순서대로 담아 두는 목록이다. 질문 7개가 하나의 목록에 차례로 들어 있고, 각 질문 안에는 보기 4개의 목록이 또 들어 있다. type에 적힌 영어 이름이 그 보기가 점수를 주는 집사 유형이다.
이렇게 바꾸고 나니 좋은 점이 컸다.
- 질문 문구를 고칠 때 이 데이터 파일만 보면 된다. 화면을 움직이는 코드는 건드릴 필요가 없다.
- 질문을 하나 더 넣고 싶으면 같은 모양으로 한 덩어리만 추가하면 된다.
- 진행도(3/7)도 목록 길이를 세서 자동으로 표시된다.
- 나중에 영어판, 일본어판을 만들 때도 이 파일만 언어별로 따로 만들면 됐다.
코드를 몰라도 이 목록 부분은 문서처럼 읽을 수 있었다. 앱 전체에서 내가 직접 고치는 첫 부분이 됐다.
직접 해 보며 조정한 것
- 보기 순서: 특정 유형의 보기가 늘 같은 자리에 있으면 사용자가 눈치챈다. 질문마다 순서를 섞었다.
- 보기 길이: 너무 길면 휴대폰에서 두세 줄로 넘어간다. 한 줄 안에 들어오도록 줄였다.
- 웃음 포인트: “내일의 나에게 위임한다”, “못 들은 척 눈을 질끈 감는다” 같은 보기는 반응이 좋았다. 세계관의 톤인 “귀엽고 따뜻하게, 위트는 살짝”을 지키려고 날 선 표현은 뺐다.
남은 문제는 마지막 계산이었다. 점수가 가장 높은 유형을 어떻게 고를지, 점수가 같으면 어떻게 할지. 여기서 처음으로 조건문을 이해하게 됐다.
이전 글: 3초 안에 마음을 잡아라! 앱 첫 화면 만드는 법
다음 글: 조건문, “만약에” 한 마디면 끝! 앱이 알아서 결과를 고르는 원리